Registros en formato FHIR: guía técnica para desarrolladores en España
Descubre cómo implementar registros en formato FHIR en España. Aprende sobre recursos clínicos, serialización en JSON y XML, y optimiza el intercambio de...
Registros en formato FHIR: guía técnica para desarrolladores en España
Un registro en formato FHIR es un conjunto de recursos HL7 FHIR que modela datos clínicos de un paciente mediante tipos estructurados como Patient, Encounter, Observation, Composition y Bundle, serializados en JSON o XML para intercambio individual, o en NDJSON para exportaciones masivas mediante Bulk Data. Cada recurso es una unidad modular e independiente; los Bundles los agrupan para enviarlos de forma atómica o como documento clínico compuesto.
Los tres formatos de representación que encontrarás en la práctica son:
- JSON (
application/fhir+json) y XML (application/fhir+xml): serializaciones estándar para recursos individuales y Bundles en APIs RESTful. - NDJSON (
application/fhir+ndjson): un recurso por línea, diseñado para la operación$exportde Bulk Data y el procesamiento en streaming. - Bundle: contenedor que agrupa varios recursos con un tipo (
transaction,batch,document) que determina la semántica de la operación.
Los perfiles y guías de implementación (IG) restringen y extienden la especificación base para un contexto concreto. En España, la guía ÚNICAS del Ministerio de Sanidad define StructureDefinitions, extensiones obligatorias y requisitos de meta.tag para enfermedades raras. Validar contra esa guía, y no solo contra la especificación base, es la diferencia entre una implementación que funciona en producción y una que falla en el primer intercambio real.
Puntos clave
Los registros en formato FHIR requieren validar contra el perfil local (no solo la spec base), usar NDJSON para exportaciones masivas y aplicar OAuth2/SMART para el control de acceso desde el primer día.
| Punto | Detalles |
|---|---|
| Valida contra el IG local | Usa el HL7 FHIR Validator con el StructureDefinition de ÚNICAS u otro perfil destino, no solo la spec base. |
| NDJSON para exportaciones masivas | Implementa $export con Prefer: respond-async y compresión gzip para extracciones poblacionales eficientes. |
| Bundle transaction para atomicidad | Agrupa Patient, Encounter y MedicationRequest en un Bundle tipo transaction para garantizar consistencia referencial. |
| OAuth2/SMART desde el inicio | Define scopes mínimos y restringe acceso por Patient Compartment antes de cargar datos reales en producción. |
| Trazabilidad en migraciones | Conserva el identificador del sistema origen en identifier y usa actualizaciones condicionales para evitar duplicados. |
Tabla de contenidos
- ¿Qué es HL7 FHIR y por qué importa para los registros clínicos?
- ¿Qué recursos FHIR componen un registro clínico típico?
- ¿Qué formatos de archivo admite FHIR y cuándo usar cada uno?
- Bundles y tipos de operación: ¿cuándo usar transaction, batch o document?
- Operaciones y endpoints FHIR que debes conocer
- ¿Cómo funcionan los perfiles FHIR y qué es la guía ÚNICAS en España?
- ¿Qué herramientas de validación necesitas como desarrollador?
- Seguridad y cumplimiento en España: GDPR, acceso y cifrado en APIs FHIR
- Cómo convertir datos desde sistemas heredados al formato FHIR
- Ejemplo práctico: Bundle tipo document y NDJSON para exportación
- Medfiles y la gestión de registros FHIR en la práctica
- Lo que la mayoría de guías FHIR no te dice
- Fuentes
¿Qué es HL7 FHIR y por qué importa para los registros clínicos?
HL7 FHIR (Fast Healthcare Interoperability Resources) es la especificación de HL7 International para modelar e intercambiar información clínica mediante recursos modulares accesibles a través de una API RESTful. Su ventaja frente a HL7 v2 o CDA no es solo técnica: los recursos FHIR son legibles por humanos en JSON, se consumen con cualquier cliente HTTP y se documentan con herramientas estándar de desarrollo web.
El núcleo del estándar distingue dos capas. La especificación base define los tipos de recursos, sus elementos obligatorios y opcionales, y las operaciones RESTful. Las guías de implementación (IG) toman esa base y la restringen para un caso de uso concreto: añaden extensiones, fijan bindings de terminología (SNOMED CT, LOINC, ICD-10) y declaran qué elementos son obligatorios en ese contexto.
Frente a HL7 v2, FHIR elimina el parsing de segmentos delimitados por pipes y ofrece un modelo de datos consistente con tipos primitivos bien definidos. Frente a CDA, la granularidad de recursos permite consultar un Observation concreto sin descargar el documento completo. Esa combinación de accesibilidad de API y representación estructurada es lo que hace de FHIR el estándar de referencia para la interoperabilidad en salud hoy.
Consejo profesional: Dibuja un diagrama de recursos antes de escribir código: un nodo por recurso (Patient, Encounter, Observation) con flechas de referencia. Ese mapa te ahorrará refactorizaciones cuando descubras que un Observation referencia un Encounter que aún no existe en el servidor.
¿Qué recursos FHIR componen un registro clínico típico?
Los registros clínicos en formato FHIR no son monolíticos. Se construyen combinando recursos especializados, cada uno con una responsabilidad concreta. La tabla siguiente recoge los recursos más frecuentes en un Registro Digital de Atención (RDA) y su función principal.
| Recurso | Uso típico en un RDA | Notas de compatibilidad |
|---|---|---|
| Patient | Datos demográficos e identificadores del paciente | R4 y R5; extensiones de identidad nacional (DNI, CIP) |
| Encounter | Episodio asistencial (consulta, ingreso, urgencia) | Referencia a Patient y a Practitioner |
| Observation | Constantes vitales, resultados de laboratorio, hallazgos | Puede agrupar sub-observaciones con hasMember |
| Composition | Índice del documento clínico; primera entrada en Bundle tipo document | Obligatorio en Bundle.type=document |
| Bundle | Contenedor de recursos; tipo determina semántica (transaction, batch, document) | Tipo document requiere Composition como entry[0] |
| DocumentReference | Referencia a documentos externos (PDF, imagen DICOM) | Útil para adjuntar informes escaneados |
| DiagnosticReport | Informe diagnóstico con resultados y conclusión narrativa | Agrupa Observations relacionadas |
| MedicationRequest | Prescripción de medicamento con dosis y pauta | Referencia a Patient y a Encounter |
La Composition actúa como índice: lista las secciones del documento y referencia los recursos que las componen. Cuando envías un Bundle de tipo document, la Composition debe ser siempre la primera entrada (entry[0]). Para Registros Digitales de Atención se recomienda este patrón con IDs locales (por ejemplo, ServiceRequest-0) que el servidor mapea a IDs persistentes tras procesar la transacción.
Sobre versiones: R4 es la versión más desplegada en producción en España y en los principales servicios en la nube. R5 introduce mejoras en el modelo de suscripciones y en la gestión de permisos, pero la compatibilidad con R4 no es automática; los cambios en algunos tipos de datos (como CodeableReference) requieren transformaciones explícitas al migrar.
¿Qué formatos de archivo admite FHIR y cuándo usar cada uno?
FHIR define dos serializaciones oficiales para recursos individuales y Bundles:
- JSON (
application/fhir+json): el formato más usado en APIs modernas. Compacto, compatible con cualquier cliente HTTP y fácil de depurar con herramientas comojq. - XML (
application/fhir+xml): obligatorio en algunos contextos de integración con sistemas heredados que ya consumen XML (HL7 CDA, servicios SOAP).
Para exportaciones masivas, la especificación Bulk Data Access define NDJSON (application/fhir+ndjson) como formato de salida: un recurso FHIR completo por línea, sin comas entre objetos, lo que permite leer el fichero en streaming sin cargarlo entero en memoria. Un ejemplo mínimo de dos líneas NDJSON:
{"resourceType":"Patient","id":"p001","meta":{"profile":["https://unicas-fhir.sanidad.gob.es/StructureDefinition/UNICASPatient"]},"name":[{"family":"García","given":["Ana"]}]}
{"resourceType":"Observation","id":"obs001","status":"final","subject":{"reference":"Patient/p001"},"code":{"coding":[{"system":"http://loinc.org","code":"8867-4","display":"Heart rate"}]},"valueQuantity":{"value":72,"unit":"bpm"}}
Cada línea es un JSON válido e independiente. Los ficheros de salida de $export se comprimen habitualmente con gzip (Accept-Encoding: gzip), lo que reduce el tamaño de transferencia de forma significativa en exportaciones poblacionales.
- Usa Bundle tipo document cuando necesites enviar un registro clínico completo y autónomo que deba preservar su integridad como documento (historia clínica de alta, informe de consulta).
- Usa NDJSON + $export cuando necesites extraer grandes volúmenes de datos para análisis, migración o carga en un data warehouse clínico.
- Usa recursos individuales (POST/PUT) para actualizaciones incrementales de un dato concreto (nueva Observation de laboratorio, actualización de MedicationRequest).
Consejo profesional: Cuando proceses ficheros NDJSON de gran tamaño, usa jq en modo streaming (jq -c línea a línea) o Apache Spark con el conector FHIR. Cargar el fichero completo en memoria con un parser JSON estándar es el error más frecuente en pipelines de Bulk Data.
Bundles y tipos de operación: ¿cuándo usar transaction, batch o document?
El tipo de Bundle no es un detalle menor: determina si el servidor procesa las entradas de forma atómica, independiente o como documento clínico.
Bundle.type = transaction garantiza que todas las operaciones del Bundle se ejecutan o ninguna. Si el servidor no puede crear el Patient y el Encounter juntos, devuelve un error y no persiste ninguno de los dos. Es el patrón correcto para crear un registro clínico completo en un solo paso.
Bundle.type = batch envía varias operaciones en una sola petición HTTP, pero cada una se procesa de forma independiente. Una puede fallar sin afectar a las demás. Útil para actualizaciones masivas donde la atomicidad no es necesaria.
Bundle.type = document empaqueta un documento clínico compuesto con Composition como primera entrada. No es una operación transaccional; es un artefacto de intercambio que representa un documento firmado y fechado.
Para construir una transacción que cree Patient + Encounter + MedicationRequest en un solo POST:
- Crea el Bundle con
"type": "transaction". - Añade cada recurso como una entrada con
request.method(POST o PUT) yrequest.url. - Usa referencias locales con el prefijo
urn:uuid:o el patrón#TypeNpara vincular recursos antes de que el servidor asigne IDs persistentes. Por ejemplo, el MedicationRequest referencia al Encounter como"reference": "urn:uuid:encounter-local-001". - Envía el Bundle con POST al endpoint base del servidor FHIR.
- El servidor devuelve un Bundle de respuesta con los IDs asignados o un OperationOutcome con los errores.
Las referencias locales en Bundles de transacción son la práctica estándar para preservar la integridad referencial cuando los recursos aún no tienen IDs persistentes en el servidor. El servidor resuelve esas referencias internas antes de persistir los recursos.
Operaciones y endpoints FHIR que debes conocer
Las operaciones RESTful estándar cubren la mayoría de los flujos cotidianos:
- GET
[base]/Patient/[id]: lectura de un recurso por ID. - POST
[base]/Patient: creación de un nuevo recurso. - PUT
[base]/Patient?identifier=https://sistema.es|12345: actualización condicional por identificador de negocio (DNI, CIP). Evita duplicados sin conocer el ID interno del servidor. - DELETE
[base]/Observation/[id]: eliminación lógica o física según la implementación del servidor. - POST
[base]/con Bundle tipo transaction: operación atómica sobre múltiples recursos.
Las operaciones especiales más relevantes para exportación y validación son:
$exporten[base]/$export,[base]/Patient/$exporto[base]/Group/[id]/$export: inicia una exportación masiva asíncrona. Requiere la cabeceraPrefer: respond-async. El servidor devuelve un202 Acceptedcon una URL de estado; cuando el trabajo termina, esa URL devuelve el manifiesto JSON con las URLs de los ficheros NDJSON. Los parámetros_since(fecha de corte) y_type(tipos de recurso) permiten exportaciones incrementales y selectivas.$validate: valida un recurso o Bundle contra un perfil. Devuelve un OperationOutcome con errores, advertencias e información.$convert-data: disponible en algunos proveedores (como Google Cloud Healthcare API) para transformar mensajes HL7 v2 o CDA a recursos FHIR directamente en el servidor.
Los servicios FHIR en la nube como Azure Health Data Services exponen estos endpoints y requieren autenticación OAuth2/SMART on FHIR. El flujo de autorización sigue el estándar SMART: el cliente obtiene un token del servidor de autorización con los scopes necesarios (patient/*.read, system/Patient.write) y lo incluye en cada petición como Authorization: Bearer [token]. Google Cloud Healthcare API sigue un patrón equivalente con IAM y tokens de acceso de Google.
¿Cómo funcionan los perfiles FHIR y qué es la guía ÚNICAS en España?
Un StructureDefinition es el artefacto que define un perfil FHIR: especifica qué elementos son obligatorios, qué bindings de terminología aplican, qué extensiones se añaden y cuáles son los invariantes de validación. Cuando un servidor valida un recurso contra un perfil, comprueba que el recurso cumple todas esas restricciones, no solo las de la especificación base.
En España, la guía ÚNICAS (Unidades de Referencia para Enfermedades Raras) del Ministerio de Sanidad es la referencia más completa de implementación FHIR publicada hasta la fecha. Define StructureDefinitions específicos para el contexto español e incluye extensiones obligatorias que no existen en la spec base:
- EdadPaciente: edad del paciente en el momento del registro.
- NodoCCAA: nodo de la comunidad autónoma responsable del caso.
- EstadoEnrolamientoPaciente: estado del paciente en el proceso de enrolamiento en la unidad de referencia.
Los ejemplos JSON de ÚNICAS muestran cómo declarar meta.tag obligatorios y cómo estructurar los recursos para que pasen la validación del IG. El ejemplo de Patient de ÚNICAS incluye meta.profile apuntando a StructureDefinition/UNICASPatient y las extensiones EdadPaciente, NodoCCAA y MomentosUnicas.
Para publicar tus propios perfiles, usa IG Publisher (la herramienta oficial de HL7) junto con un repositorio Git. El IG Publisher genera la documentación HTML, los artefactos JSON/XML de los StructureDefinitions y los ejemplos validados. Incluye siempre la URL del perfil en meta.profile de cada recurso que envíes: es la señal que indica al validador qué StructureDefinition debe aplicar.
Advertencia técnica: El error más frecuente en implementaciones FHIR en España es validar los recursos contra la especificación base de HL7 en lugar de contra el IG local (ÚNICAS u otro). Un recurso que pasa la validación base puede fallar en producción si le faltan extensiones obligatorias del perfil destino o si usa un ValueSet distinto al que exige la guía. Siempre valida contra el StructureDefinition del sistema receptor, no contra la spec genérica.
¿Qué herramientas de validación necesitas como desarrollador?
Las herramientas de validación son parte del flujo de desarrollo, no un paso opcional al final. Estas son las más útiles en la práctica:
- HL7 FHIR Validator (
validator_cli.jar): la herramienta oficial de HL7. Valida recursos y Bundles contra la spec base o contra un IG local especificando la URL del perfil con-profile. Ejecutable desde línea de comandos, ideal para integrar en pipelines CI/CD. - HAPI FHIR: biblioteca Java de referencia para parsear, construir y validar recursos FHIR. Incluye un servidor FHIR completo (HAPI FHIR JPA Server) que puedes desplegar localmente para pruebas de integración.
- IG Publisher: genera y valida guías de implementación completas. Útil cuando desarrollas o mantienes perfiles propios.
- Validadores en la nube: Azure Health Data Services y Google Cloud Healthcare API exponen
$validatedirectamente en el servidor, lo que permite validar contra los perfiles cargados sin infraestructura adicional. jq: imprescindible para inspeccionar y transformar ficheros NDJSON en la línea de comandos. Combínalo consplitpara procesar exportaciones grandes en fragmentos.
Para integrar validación en un pipeline CI/CD, añade un job que ejecute fhir-validator contra el IG de destino antes de cada despliegue. Un ejemplo básico en un workflow de GitHub Actions:
- name: Validar recursos FHIR
  run: java -jar validator_cli.jar ./resources/ -ig https://unicas-fhir.sanidad.gob.es -profile https://unicas-fhir.sanidad.gob.es/StructureDefinition/UNICASPatient
Cuando un recurso falla la validación, el servidor devuelve un OperationOutcome con la lista de errores, su severidad (error, warning, information) y la ruta XPath/FHIRPath del elemento problemático. Aprende a leer OperationOutcomes antes de depurar a ciegas: contienen exactamente la información que necesitas.
Consejo profesional: Mantén un conjunto de recursos de ejemplo válidos en tu repositorio y ejecútalos contra el validador en cada PR. Detectar una rotura de perfil en CI es trivial; detectarla en producción, después de haber enviado mil registros mal formados, no lo es.
Seguridad y cumplimiento en España: GDPR, acceso y cifrado en APIs FHIR
Los datos clínicos son datos personales de categoría especial bajo el RGPD (Reglamento General de Protección de Datos). Cualquier implementación FHIR en España debe cumplir con sus requisitos antes de procesar el primer recurso Patient.
Los principios más relevantes para APIs FHIR son la minimización de datos (no exponer más campos de los necesarios en cada operación) y la base legal (consentimiento explícito del paciente o habilitación legal para el tratamiento). Los endpoints de búsqueda son especialmente sensibles: un GET [base]/Patient?name=García puede devolver datos de múltiples pacientes si no se aplican controles de acceso por compartimento.
El modelo de control de acceso recomendado para FHIR es SMART on FHIR: define scopes granulares (patient/Observation.read, system/MedicationRequest.write) que limitan qué recursos puede leer o escribir cada cliente. Los tokens deben tener expiración corta, rotarse regularmente y revocarse cuando el usuario cierra sesión o revoca el consentimiento.
Lista de comprobación operativa para implementaciones en España:
- TLS 1.2 o superior en todos los endpoints (cifrado en tránsito).
- Cifrado en reposo para bases de datos y almacenamiento de ficheros NDJSON.
- Logs de auditoría con registro de quién accedió a qué recurso y cuándo (compatible con el recurso AuditEvent de FHIR).
- Pseudonimización de identificadores directos (DNI, nombre) en entornos de investigación o analítica.
- Gestión de consentimientos con el recurso Consent de FHIR o integración con un sistema externo de gestión de consentimientos.
- Tokens OAuth2 con scopes mínimos necesarios, sin scopes de administración en clientes de usuario final.
Consejo profesional: Implementa el Patient Compartment de FHIR desde el primer día: restringe que cada cliente autenticado solo pueda acceder a los recursos del paciente para el que tiene autorización. Añadir esa restricción después de tener datos en producción es mucho más costoso que diseñarla desde el inicio.
Para más detalles sobre compartición segura de documentos médicos, los principios de control de acceso y cifrado aplican tanto a APIs FHIR como a plataformas de gestión de registros.
Cómo convertir datos desde sistemas heredados al formato FHIR
La migración desde HL7 v2 o bases de datos hospitalarias a FHIR no es un problema de sintaxis. Es un problema de modelado y de gestión de identidades. Estos son los pasos que funcionan en la práctica:
- Inventario de campos: documenta todos los campos del sistema origen, su tipo, cardinalidad y semántica. Incluye los identificadores de paciente (NHC, CIP, DNI) y los códigos de terminología usados.
- Seleccionar perfiles destino: decide contra qué IG vas a validar (ÚNICAS, un perfil propio, la spec base). Esto determina qué extensiones y bindings debes respetar.
- Diseñar el mapeo: campo a campo, de origen a elemento FHIR. Documenta las transformaciones necesarias (conversión de fechas, normalización de códigos, concatenación de campos de nombre).
- Implementar las transformaciones: construye el pipeline ETL. Herramientas como HAPI FHIR (Java),
fhir-works-on-awso los conectores de Google Cloud Healthcare API pueden acelerar este paso. - Validar en staging: ejecuta el validador contra el IG destino antes de cargar en producción. Corrige errores de perfil, bindings rotos y referencias inválidas.
- Testear con datos reales anonimizados: los datos sintéticos no cubren todos los casos extremos. Usa un subconjunto anonimizado del sistema origen para detectar problemas de codificación o campos vacíos inesperados.
Los errores más frecuentes en migraciones son:
- Validar solo contra la spec base e ignorar el IG local.
- Usar códigos de terminología propietarios sin mapear a SNOMED CT, LOINC o ICD-10.
- Crear duplicados de Patient por no implementar actualizaciones condicionales (
PUT [base]/Patient?identifier=sistema|valor). - Referencias rotas en Bundles porque el recurso referenciado no se incluyó en la misma transacción.
Un mapeo típico de HL7 v2 a FHIR: el segmento PV1 (visita del paciente) se convierte en un recurso Encounter con los campos de tipo de visita, fechas de ingreso/alta y referencias al Patient. Los segmentos OBR/OBX (solicitud y resultado de observación) se convierten en DiagnosticReport y Observation respectivamente, con los códigos LOINC correspondientes en code.coding.
Conserva siempre el identificador original del sistema fuente en identifier con el sistema URI del origen. Eso garantiza trazabilidad y permite deduplicar si el mismo registro llega dos veces.
Ejemplo práctico: Bundle tipo document y NDJSON para exportación
Un Bundle tipo document mínimo con Patient, Encounter y Observation tiene esta estructura esquemática en JSON:
{
  "resourceType": "Bundle",
  "type": "document",
  "entry": [
    {
      "fullUrl": "urn:uuid:composition-001",
      "resource": {
        "resourceType": "Composition",
        "status": "final",
        "type": { "coding": [{ "system": "http://loinc.org", "code": "34133-9" }] },
        "subject": { "reference": "urn:uuid:patient-001" },
        "section": [{ "entry": [{ "reference": "urn:uuid:encounter-001" }] }]
      }
    },
    {
      "fullUrl": "urn:uuid:patient-001",
      "resource": {
        "resourceType": "Patient",
        "meta": { "profile": ["https://unicas-fhir.sanidad.gob.es/StructureDefinition/UNICASPatient"] },
        "id": "patient-001",
        "name": [{ "family": "García", "given": ["Ana"] }]
      }
    },
    {
      "fullUrl": "urn:uuid:encounter-001",
      "resource": {
        "resourceType": "Encounter",
        "status": "finished",
        "subject": { "reference": "urn:uuid:patient-001" }
      }
    },
    {
      "fullUrl": "urn:uuid:obs-001",
      "resource": {
        "resourceType": "Observation",
        "status": "final",
        "subject": { "reference": "urn:uuid:patient-001" },
        "encounter": { "reference": "urn:uuid:encounter-001" },
        "code": { "coding": [{ "system": "http://loinc.org", "code": "8867-4" }] },
        "valueQuantity": { "value": 72, "unit": "bpm" }
      }
    }
  ]
}
La salida equivalente de una operación $export de Bulk Data serían dos ficheros NDJSON separados (uno por tipo de recurso), con una línea por recurso:
{"resourceType":"Patient","id":"patient-001","meta":{"profile":["https://unicas-fhir.sanidad.gob.es/StructureDefinition/UNICASPatient"]},"name":[{"family":"García","given":["Ana"]}]}
{"resourceType":"Observation","id":"obs-001","status":"final","subject":{"reference":"Patient/patient-001"},"code":{"coding":[{"system":"http://loinc.org","code":"8867-4"}]},"valueQuantity":{"value":72,"unit":"bpm"}}
El manifiesto JSON del $export incluye un campo output con las URLs de los ficheros, un campo deleted para recursos eliminados desde la última exportación y un campo error con ficheros NDJSON que contienen OperationOutcomes de recursos que no pudieron exportarse. Procesa siempre el fichero de errores antes de dar por completada una exportación.
La tabla siguiente describe los campos más relevantes de los fragmentos anteriores:
| Campo | Recurso | Propósito |
|---|---|---|
resourceType |
Todos | Identifica el tipo de recurso FHIR |
id |
Todos | Identificador único en el servidor |
meta.profile |
Patient | URL del StructureDefinition que debe cumplir el recurso |
fullUrl |
Entradas de Bundle | Referencia local usada para vincular recursos dentro del Bundle |
reference |
Observation, Encounter | Referencia a otro recurso (Patient, Encounter) |
code.coding.system |
Observation | URI del sistema de terminología (LOINC, SNOMED CT) |
valueQuantity |
Observation | Valor numérico con unidad (resultado de laboratorio, constante vital) |
Medfiles y la gestión de registros FHIR en la práctica
Medfiles está diseñado para que tanto pacientes como profesionales puedan gestionar registros médicos digitales con seguridad y sin fricciones técnicas. La plataforma admite la ingestión de documentos clínicos estructurados, incluyendo Bundles y ficheros NDJSON, y los organiza automáticamente por tipo de recurso y fecha.
La infraestructura de Medfiles opera con cifrado extremo a extremo y cumplimiento HIPAA-ready, lo que la alinea con los requisitos de seguridad del RGPD aplicables en España. Los mecanismos de compartición segura permiten enviar registros a profesionales sanitarios con control granular sobre quién accede y durante cuánto tiempo, sin exponer datos innecesarios.
Para profesionales, la plataforma ofrece un flujo de recepción y revisión de documentos clínicos que no requiere integración técnica previa. Los médicos pueden recibir y visualizar registros directamente desde la sección para profesionales de Medfiles, con acceso inmediato a los documentos relevantes del paciente.
El pipeline de ingestión incluye validación y organización automática de los documentos subidos, con soporte para múltiples perfiles de paciente en una sola cuenta, lo que facilita la gestión de registros familiares o de pacientes bajo tutela. La autenticación sigue estándares compatibles con OAuth2, y las opciones de alerta por WhatsApp garantizan acceso inmediato en situaciones de emergencia o durante viajes.
¿Quieres integrar tus registros clínicos en una plataforma segura y accesible? Empieza con Medfiles y gestiona tus documentos médicos con cifrado, organización automática y acceso instantáneo desde cualquier dispositivo.
Lo que la mayoría de guías FHIR no te dice
La mayor parte de la documentación técnica sobre FHIR se centra en la sintaxis: cómo serializar un Patient, cómo construir un Bundle, cómo llamar a $export. Todo eso es necesario, pero no es donde fallan las implementaciones reales.
El problema más frecuente en proyectos FHIR en España no es técnico. Es de gobernanza: nadie decide desde el principio contra qué perfil se va a validar. Los equipos construyen meses de pipeline asumiendo que la spec base es suficiente, y cuando llega el momento de integrarse con el sistema receptor (que exige ÚNICAS, o un perfil propio del hospital), descubren que cientos de recursos no pasan la validación. Rehacer el mapeo con datos ya en producción es costoso y arriesgado.
La segunda trampa es la gestión de identidades. FHIR no resuelve el problema de deduplicación de pacientes: si tu sistema origen tiene tres registros del mismo paciente con identificadores distintos, FHIR los convertirá en tres recursos Patient distintos a menos que implementes actualizaciones condicionales desde el primer día. El DNI o el CIP como identificador de negocio en identifier es la solución más directa, pero requiere que el sistema origen los tenga correctamente registrados.
Por último, la seguridad. OAuth2/SMART on FHIR no es complicado de implementar, pero sí es fácil de posponer. Los proyectos que arrancan con autenticación básica o sin control de acceso por compartimento acaban con APIs que exponen datos de pacientes que no deberían ser accesibles para ese cliente. En un entorno regulado por el RGPD, eso no es un riesgo técnico: es una obligación legal.
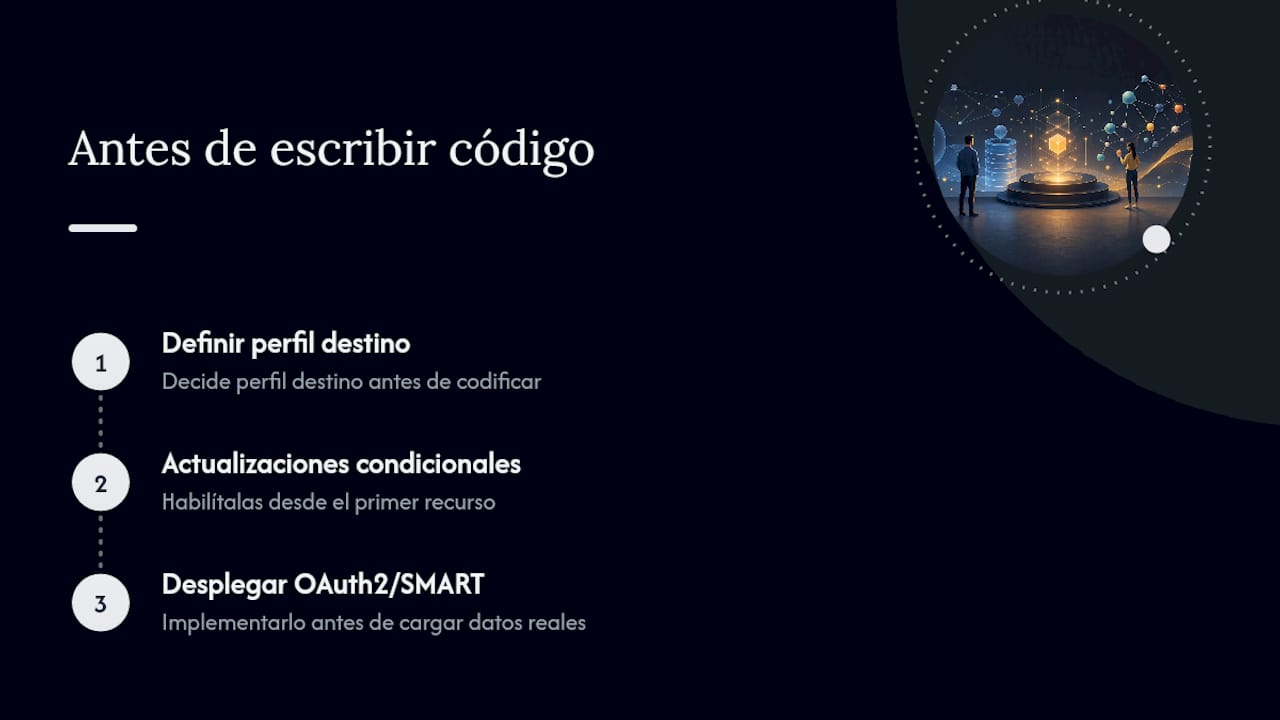
La recomendación práctica es simple: decide el perfil destino antes de escribir una línea de código, implementa actualizaciones condicionales desde el primer recurso y despliega OAuth2/SMART antes de cargar datos reales.
Este artículo es información general y no sustituye el consejo de un médico cualificado. Consulte a un profesional de la salud cualificado sobre su caso particular antes de actuar según este contenido.
Fuentes
El orden de lectura recomendado es: especificación base, luego el IG local, después las herramientas de validación y finalmente los ejemplos NDJSON.
- FHIR Bulk Data Access (Flat FHIR)
- Ejemplos de mensajería - ÚNICAS Rare Diseases HL7 FHIR Implementation Guide v0.0.7
Sobre versiones: DSTU2 y STU3 son versiones históricas con adopción residual en sistemas muy antiguos. R4 es el estándar de facto en producción. R5 introduce mejoras en suscripciones, permisos y algunos tipos de datos, pero la migración desde R4 requiere transformaciones explícitas. Si empiezas un proyecto nuevo hoy, usa R4 y planifica la transición a R5 cuando tu ecosistema de proveedores la soporte.